Теперь собрать собственную reasoning-модель может практически любой желающий. Себастьян Рашка выпустил полностью бесплатный курс и открыл исходный код всех материалов. На примере небольшой модели Qwen3-0.6B он показывает, как на самом деле обучаются reasoning-модели и из каких этапов складывается этот процесс. В ходе курса можно разобраться, как: • научить модель искать разные пути решения одной задачи; • автоматически проверять правильность полученных ответов; • улучшать её поведение с помощью обучения по вознаграждению и GRPO; • наблюдать за тем, как модель порой находит способы обойти саму систему вознаграждений; • обучать более компактную модель на данных рассуждений DeepSeek-R1. Весь код можно запускать самостоятельно, наблюдая за ходом обучения и постепенно замечая, как меняется поведение модели. При этом начинать с самого нуля не придётся, так как в качестве исходной точки используется уже готовая небольшая модель, а не фундаментальная модель, которую пришлось бы обучать с нуля. Если вам давно хотелось понять, как устроены модели вроде DeepSeek-R1, этот курс даёт редкую возможность не просто прочитать об этом, а пройти весь путь собственными руками. https://github.com/rasbt/reasoning-from-scratch
Now almost anyone can assemble their own reasoning model.
Now almost anyone can assemble their own reasoning model. Sebastian Raschka has released a completely free course and open sourced all the materials. Using the example of a small model Qwen3-0.6B, he shows how reasoning models are actually trained and from which...
AI Summary & Key Takeaways
- Now almost anyone can assemble their own reasoning model
- Sebastian Raschka has released a completely free course and open sourced all the materials
- Using the example of a small model Qwen3-0.6B, he shows how reasoning models are actually trained and from which...
Now almost anyone can assemble their own reasoning model.
Related stories
Kimi - complete guide to the ecosystem and analysis of K3.1 Pro
Kimi - a complete guide to the ecosystem and analysis of K3.1 Pro ⠀ On October 23, Moonshot released Kimi K3.1 Pro. At the same time, we dismantled the entire ecosystem: Kimi can already create games, 3D models, websites and automate work on the Internet. ⠀ 🟠What's new in K3.1 Pro > Context - up to 1 million tokens >...
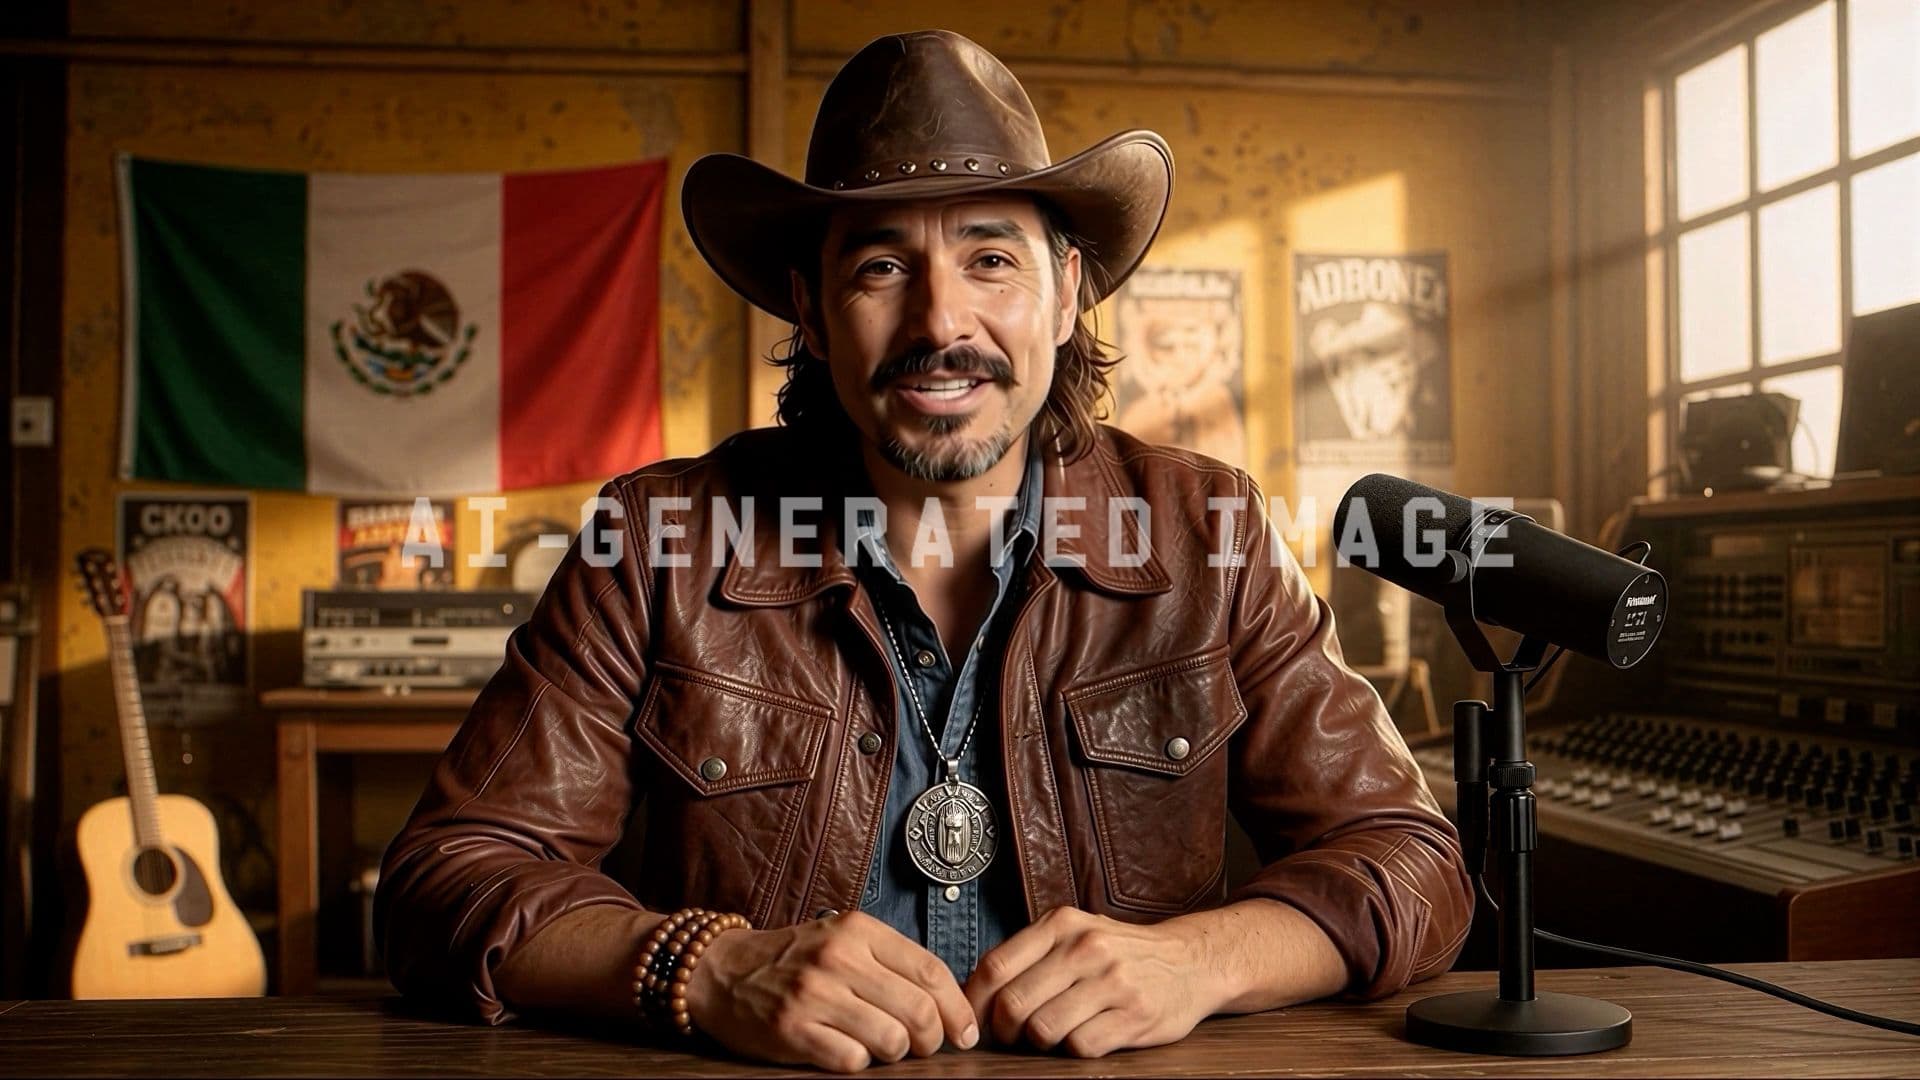
This AI Radio Host Speaks Spanish and Backs Immigrants. It’s Winning Over Listeners
Coyotec is bilingual, swears, and tells listeners how to defend themselves against ICE. Its popularity comes as more broadcasters are experimenting with artificial personalities.
Perplexity taught the model to be its own teacher
📌 Perplexity taught the model to be its own teacher. The AI search engine proposed a training method called JOLT, in which the same model acts simultaneously as both student and teacher, with both roles learning at the same time. In reinforcement learning, the model receives a reward only for…
If your AGENTS.md has become outdated, Claude Code may notice that the documentation already diverges from the actual code, and...
If your AGENTS.md has become outdated, Claude Code may notice that the documentation already diverges from the actual code, yet continue following old instructions. Researchers deliberately created this situation and ran 80 trials. In 79 cases, Claude Code recognized...